
Один сервер — це просто. Одна база даних, один запис, один результат. Проблеми починаються тоді, коли даних і користувачів стає забагато для однієї машини і доводиться розносити систему по кількох нодах, датацентрах, а іноді й континентах. І ось тут у розмову залазить CAP-теорема — абревіатура, якою любить лякати технічний директор на співбесіді, але яка насправді описує дуже приземлену інженерну дилему: під час збою мережі доведеться чимось пожертвувати, і краще вирішити, чим саме, заздалегідь.
Розберімося без магії: що таке C, A і P насправді, чому «вибрати 2 з 3» — спрощення, яке вводить в оману, і як цю теорему застосовувати на практиці, а не тільки цитувати на співбесіді.
ЩО ТАКЕ CAP-ТЕОРЕМА ПРОСТИМИ СЛОВАМИ
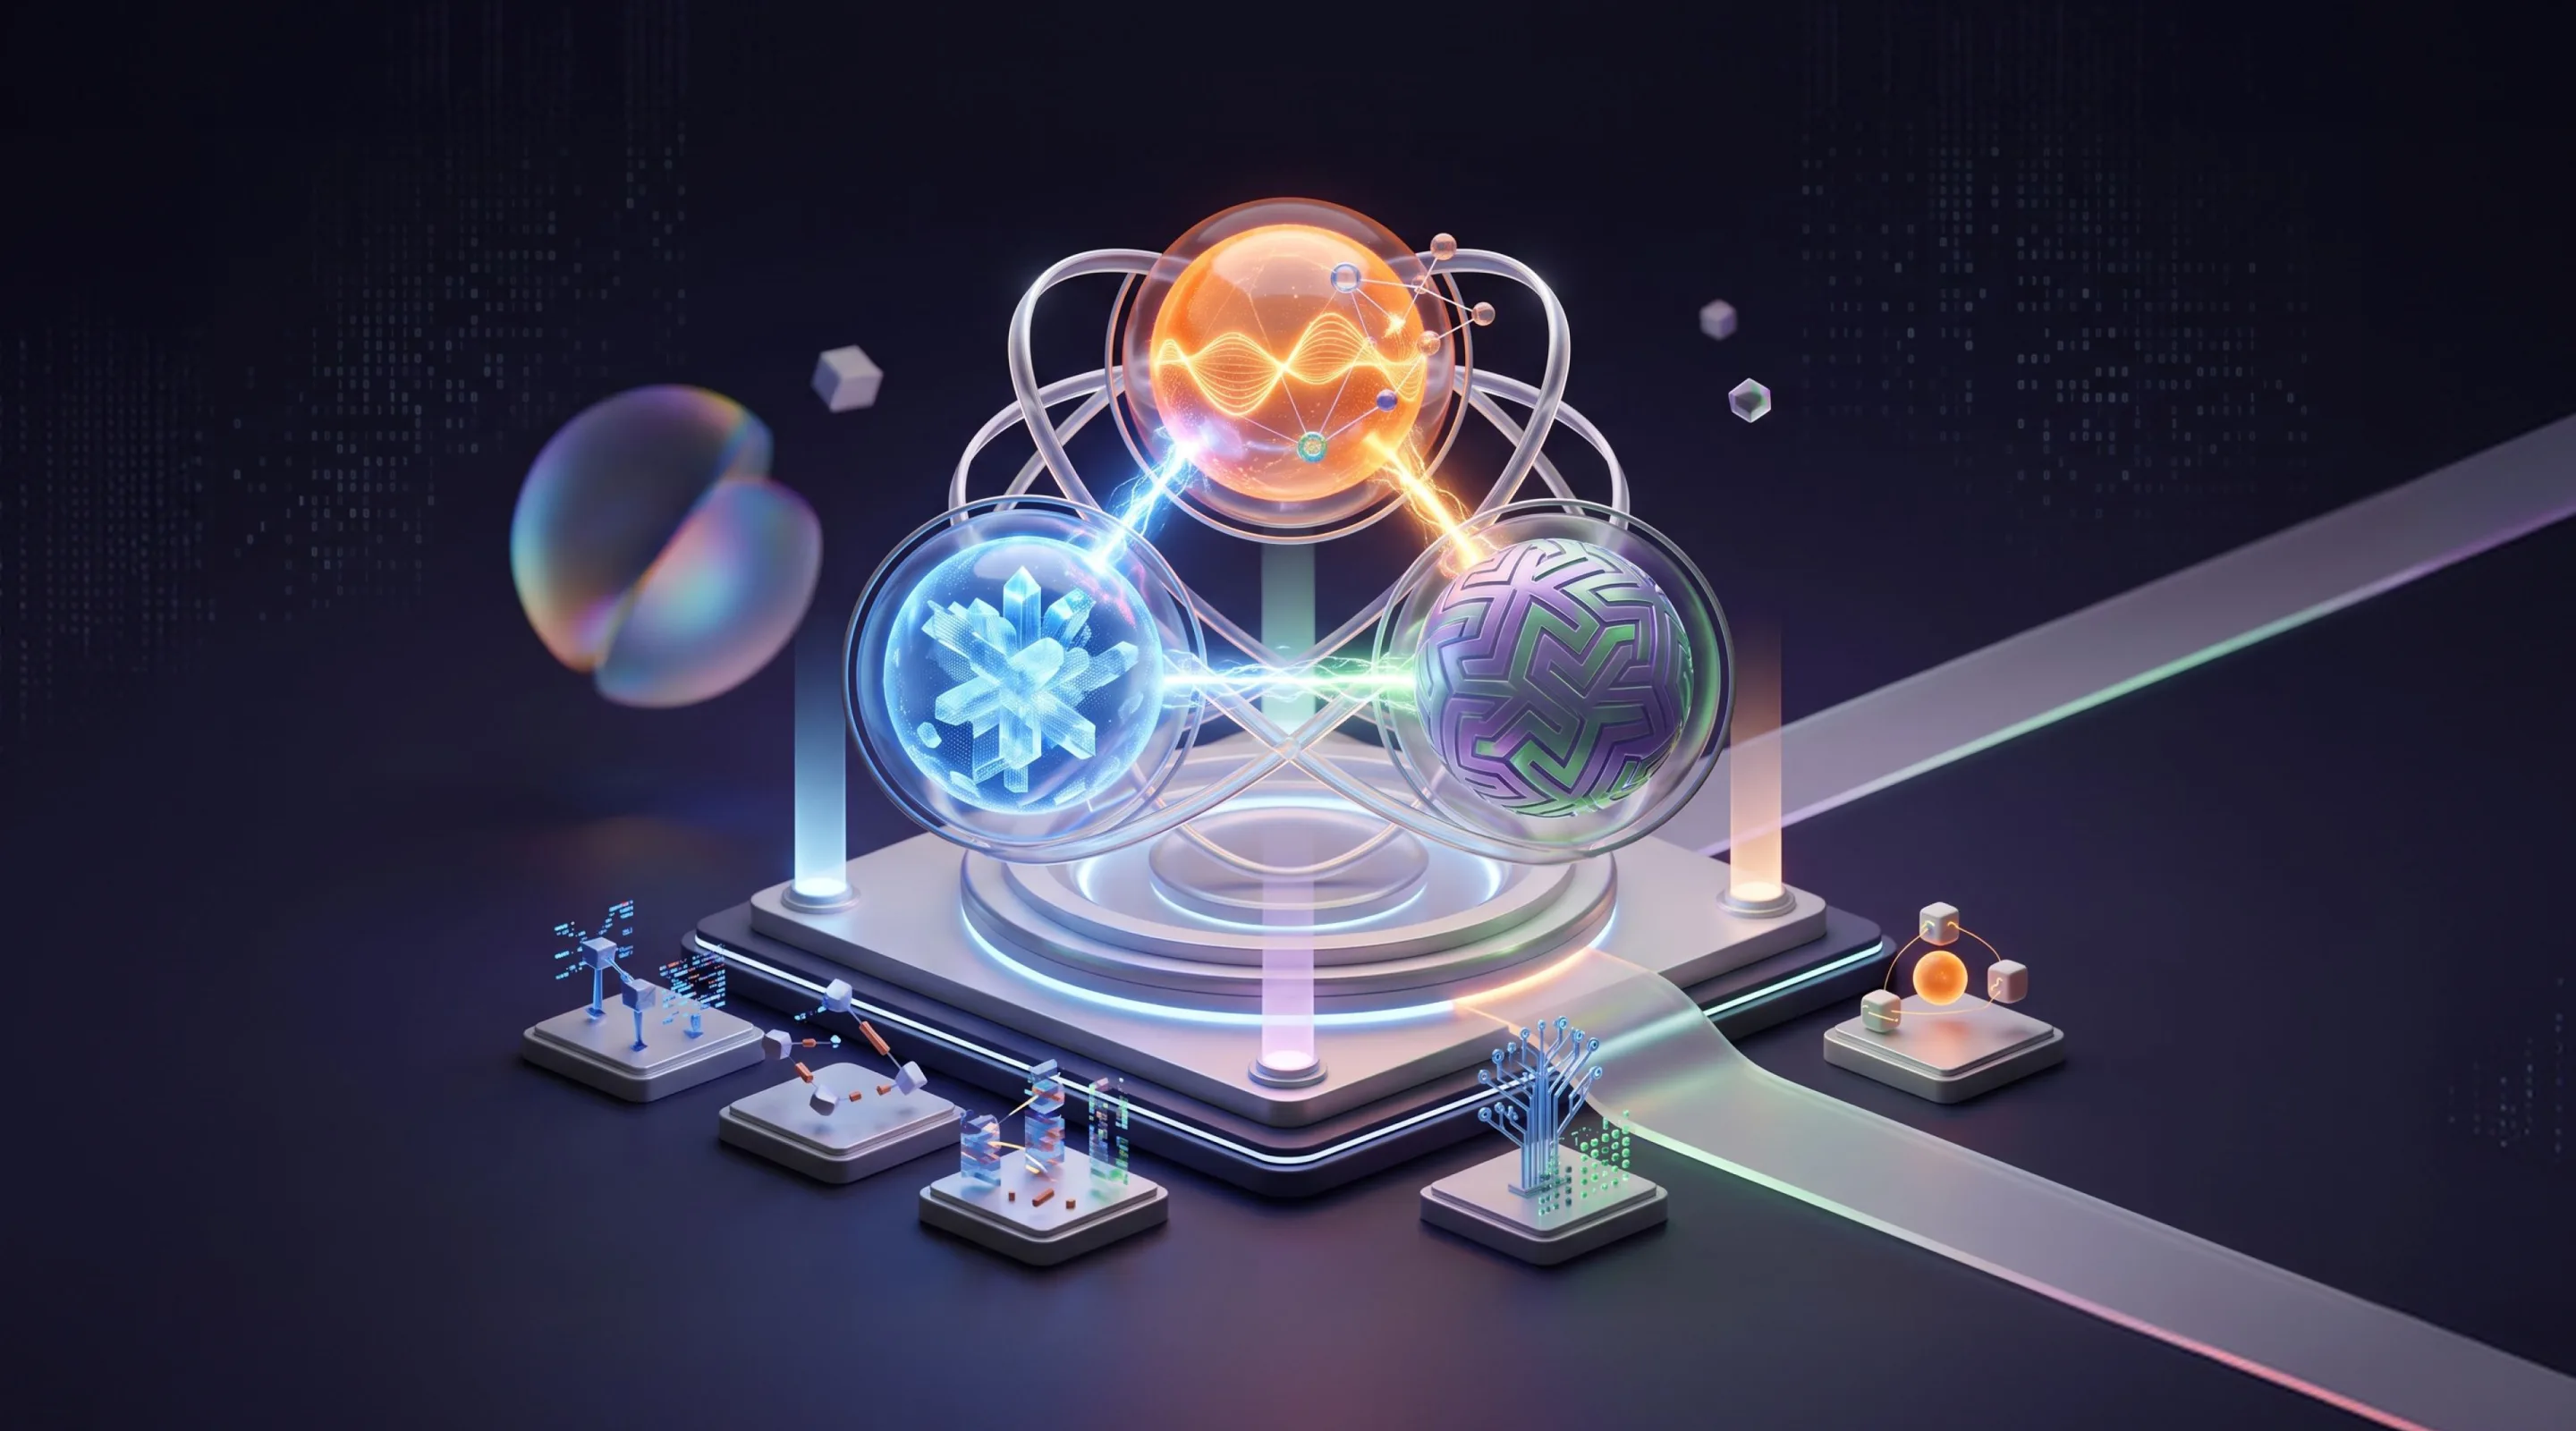
CAP-теорему сформулював Ерік Брюер у 2000 році, а формально довели Сет Гілберт і Ненсі Лінч у 2002-му. Суть: у розподіленій системі, що складається з кількох вузлів, неможливо одночасно гарантувати всі три властивості:
📌 Consistency (узгодженість) — усі клієнти в будь-який момент бачать однакові, найактуальніші дані. Якщо ти щойно записав значення, будь-яке наступне читання — з будь-якої ноди — поверне саме його, а не застарілу версію.
📌 Availability (доступність) — кожен запит до працюючої ноди отримує відповідь, навіть якщо частина системи «лежить». Ключове слово — «відповідь», а не «правильна відповідь»: система зобов'язана відповісти, але не гарантує, що дані свіжі.
📌 Partition Tolerance (стійкість до розділення мережі) — система продовжує працювати, навіть якщо мережа між вузлами розірвалася і вони тимчасово не бачать одне одного.
Класичне формулювання «вибери 2 з 3» звучить логічно, але на практиці збиває з пантелику. Тому що P — не опція, яку можна викреслити.
ЧОМУ «ВИБЕРИ 2 З 3» — НЕ ЗОВСІМ ПРАВДА
У реальному розподіленому backend мережеві розриви — це не гіпотетичний сценарій, а статистична неминучість: обірвався кабель, впав свіч, перевантажився роутер, datacenter втратив зв'язок з іншим регіоном. Якщо система складається більш ніж з однієї ноди, партиції (P) рано чи пізно трапляться.
Це означає, що насправді вибір не між C, A і P — а тільки між C і A, і то лише в момент, коли партиція вже сталася. Поки мережа стабільна, система цілком може бути й консистентною, і доступною одночасно. CAP-теорема описує компроміс не «завжди», а конкретно під час збою зв'язку між нодами.
Саме тому інженери частіше говорять не про «CA, CP чи AP системи» загалом, а про те, як конкретний backend поводиться в момент партиції: продовжує відповідати ціною застарілих даних, чи блокує запити заради коректності.
CP: КОЛИ ПРАВИЛЬНІСТЬ ВАЖЛИВІША ЗА ВІДПОВІДЬ
CP-системи (Consistency + Partition Tolerance) під час розриву мережі відмовляються відповідати тим нодам, які не можуть підтвердити, що їхні дані актуальні. Краще повернути помилку або тайм-аут, ніж віддати клієнту застарілий чи суперечливий результат.
Типові приклади:
- ZooKeeper і etcd — координаційні сервіси, на яких тримається лідер-елекшн у Kafka, Kubernetes, HDFS. Якщо кворум вузлів недосяжний — сервіс краще стане недоступним, ніж дасть двом нодам одночасно вважати себе лідером.
- MongoDB у стандартній конфігурації (запис з підтвердженням від більшості реплік) — теж ближче до CP: під час партиції меншість вузлів перестає приймати записи.
- Банківські транзакційні системи, білінг, будь-де, де подвійне списання коштів дорожче за кілька секунд простою.
Ціна CP-підходу — реальний даунтайм або підвищена латентність саме тоді, коли трафік і так під навантаженням через проблеми з мережею.
AP: КОЛИ ВІДПОВІСТИ ВАЖЛИВІШЕ, НІЖ ВІДПОВІСТИ ПРАВИЛЬНО
AP-системи (Availability + Partition Tolerance) під час партиції продовжують обслуговувати запити на кожній доступній ноді, навіть якщо вузли тимчасово розійшлися в даних. Розбіжності потім «залагоджуються» — через механізми на кшталt eventual consistency, vector clocks або last-write-wins.
Типові приклади:
- Cassandra й DynamoDB — спроєктовані так, щоб кожна нода завжди приймала запис і читання, а конфлікти реплікації розв'язувалися пізніше.
- DNS — глобально розподілена система, яка продовжує відповідати навіть при розривах, ціною того, що різні резолвери можуть якийсь час віддавати різні (застарілі) IP.
- Стрічки соцмереж, лічильники лайків, кошики в e-commerce — там, де секундна затримка синхронізації даних непомітна користувачу, а недоступність сервісу — критична і видима одразу.
Ціна AP-підходу — тимчасова неузгодженість даних: користувач може побачити старий баланс лайків, дублікат товару в кошику чи «воскреслий» видалений коментар.
PACELC: ЧОМУ CAP — ЦЕ НЕ ВСЯ ІСТОРІЯ
CAP описує тільки поведінку системи під час партиції. Але компроміс не зникає й тоді, коли мережа працює ідеально. Це доповнює PACELC-теорема (Деніел Абаді, 2010):
- Partition → вибір між Availability і Consistency (це і є класичний CAP);
- Else (у штатному режимі, без партицій) → вибір між Latency і Consistency.
Тобто навіть без жодного збою мережі система, яка хоче суворої консистентності (наприклад, синхронна реплікація на всі вузли перед підтвердженням запису), платить за це затримкою. А система, що готова читати з найближчої репліки без очікування підтвердження від усіх — виграє в латентності, але ризикує віддати трохи застарілі дані.
PACELC пояснює, чому «просто зробимо CP-систему і забудемо» — не рішення: доведеться свідомо балансувати latency й consistency щодня, а не тільки в аварійних сценаріях.
ЯК ЦЕ ВИБРАТИ ДЛЯ СВОГО BACKEND: ПРАКТИЧНІ ОРІЄНТИРИ
Правильної відповіді «CP чи AP» не існує — є відповідність вимогам конкретного домену. Кілька орієнтирів:
📌 Питайте не «яка теорема правильна», а «що дорожче для бізнесу: показати застарілі дані чи показати помилку?»
📌 Для фінансових операцій, інвентаризації складу, бронювання унікальних місць (квиток, номер у готелі) — схиляйтеся до CP: подвійне бронювання коштує репутації й грошей більше, ніж кілька секунд недоступності.
📌 Для профілів користувачів, аналітики, рекомендацій, лічильників — обирайте AP: користувач не помітить, що лайк порахувався на 200 мс пізніше, але помітить, якщо стрічка не завантажиться взагалі.
📌 Комбінуйте підходи в межах однієї системи: платіжний модуль на CP-сховищі, каталог товарів і сесії — на AP-сховищі. Мікросервісна архітектура це дозволяє.
📌 Закладайте механізми компенсації для AP-частин: idempotency-ключі, reconciliation-джоби, конфлікт-резолюшн на рівні бізнес-логіки, а не сподівання, що «якось саме розсмокчеться».
Рекомендуємо курси по темі


ВИСНОВОК: CAP — ЦЕ НЕ ВИБІР РАЗ І НАЗАВЖДИ
CAP-теорема — не магічна формула і не привід обирати одну базу даних «на віки». Це інструмент для чесної розмови про те, що станеться з вашим backend у момент, коли мережа підведе — а вона підведе. Партиції неминучі, тому реальний вибір завжди між консистентністю і доступністю, а PACELC нагадує, що цей компроміс живе в системі навіть тоді, коли все працює штатно.
Масштабування backend — це не про пошук ідеальної архітектури без компромісів, а про свідомий вибір, яким саме компромісом ви готові керувати. Розберіться, яка ціна помилки у вашому домені — і CAP-теорема з абстрактної абревіатури перетвориться на цілком конкретний архітектурний чекліст.
Рекомендуємо публікації по темі